
Kort fortalt
Cloudflare shippede 15. september 2026 indstillingen Disallow AI Training og droppede planen om at lade en træningsblokering ramme Googlebot; eksisterende Block AI Bots-valg blev migreret automatisk, og kunderne fik besked dagen efter. Indstillingen skriver en Disallow for tokenet Google-Extended i robots.txt — og både Googles crawlerdokumentation og hjælpeteksten til den generative AI-kontrol siger, at Google-Extended dækker modeltræning og grounding i Googles øvrige systemer, ikke AI-oversigter og AI Mode. 17 % af Cloudflares sites har en træningsblokering slået til, under 1 % blokerer søgebots, og netværket leverer over 20 % af nettet. Kontrollen der faktisk fjerner dig fra AI-oversigter, AI Mode og Discovers AI-funktioner ligger i Search Console, gælder hele propertyen og træder i kraft inden for et til to døgn. Sidebaserede kontroller er ikke et løfte fra Google, men et krav fra den britiske konkurrencemyndighed med en frist ni måneder efter afgørelsen: 3. marts 2027.
Cloudflares Disallow AI Training ændrer ikke, om du optræder i AI-oversigter eller AI Mode. Indstillingen skriver en robots.txt-regel for Google-Extended, og det token styrer modeltræning og grounding i Googles øvrige systemer — ikke de generative funktioner i Search. Vil du ud af AI-oversigterne, findes der én kontakt der gør det, og den ligger et helt andet sted.
Hvad Cloudflare faktisk shippede 15. september
Planen fra juli lød anderledes. Cloudflare klassificerer crawlere efter adfærd — søgning, agent, træning — og en crawler med flere formål skulle vurderes efter den mest restriktive regel der gjaldt for den. Konsekvensen var beskrevet åbent i Cloudflares eget oplæg: Googlebot, Applebot og Bingbot ville blive blokeret hos kunder der havde valgt at blokere træning. Et nej til modeltræning blev et nej til at blive indekseret.
Det blev droppet. Det der gik i luften 15. september 2026 er en ny indstilling, Disallow AI Training, hvor de tre søgemaskinecrawlere bliver ved med at crawle til søgning, mens et no-training-signal bliver udtrykt i robots.txt. Bryan Becker, Cloudflares Director of Product Security, solgte den som at få begge ting: forblive synlig i søgning og samtidig afvise AI-træning.
Prisen for at blive på den gode liste er en akkrediteringsordning. Cloudflare kalder de kvalificerede operatører «Accountable», og kravene er fire: en robots.txt-mekanisme til at fravælge AI-træning, en mekanisme til at fravælge AI-resuméer, indsigt på URL-niveau i hvilke sider der blev stillet til rådighed for træning, og en forsikring om at fravalget ikke påvirker almindelige søgeresultater. Google, Apple og Microsoft slap igennem på en blanding af det de kan i dag og daterede løfter om resten — Google med URL-niveau-værktøjer «i de kommende uger», Microsoft med robots.txt-understøttelse i begyndelsen af 2027.
Omfanget er ikke lille. 17 % af Cloudflares sites har en mekanisme slået til der blokerer træning, under 1 % blokerer søgebots, og netværket leverer over en femtedel af nettet. Eksisterende Block AI Bots-valg blev migreret automatisk til den nye indstilling, og kunderne fik migrerings-e-mailen 16. september. Det er altså sket på et stort antal sites, uanset om ejeren rørte noget.
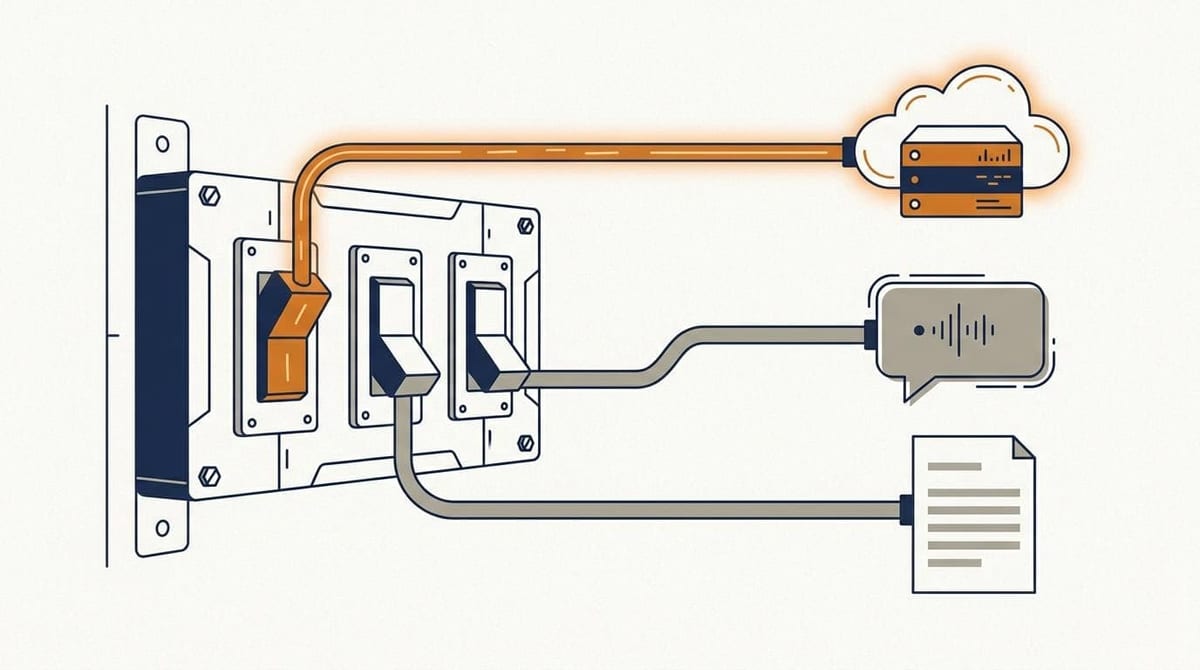
Tre kontakter, tre forskellige overflader
Her stopper de fleste dækninger, og her sniger fejlen sig ind. Disallow AI Training skriver en Disallow for tokenet Google-Extended. Googles dokumentation om AI-funktioner i Search siger, at Google-Extended handler om AI-træning og grounding i nogle af Googles andre systemer, mens det er robots.txt-reglerne for Googlebot der styrer, hvordan sitet crawles til Search — og det er Search, AI-oversigter og AI Mode hører under.
Den anden vej rundt er det lige så eksplicit. Hjælpeteksten til Search Consoles generative AI-kontrol slår fast, at kontrollen ikke bruges som rangerings- eller optagelsessignal for andre dele af Search, og at man skal bruge Google-Extended, hvis man vil begrænse træningen af de modeller der genererer svarene. To tokens, to formål, nul overlap. Sat op mod hinanden:
Diagonalen er pointen. Hver af de to øverste kontakter rammer én søjle og lader de andre stå. Nederste række er den eneste der rammer to — og den ene af dem er din egen resultatliste.
Search Console-kontrollen er den eneste der rammer AI-svarene
Kontrollen kom 6. juni 2026, samme dag som den britiske konkurrencemyndighed CMA pålagde Google at levere den. Den dækker AI-oversigter, AI Mode og de generative funktioner i Discover, den bruges ikke som signal andre steder i Search, og indholdet er ude inden for et til to døgn — med et forbehold om caching og propagering, som er Googles eget og værd at tage alvorligt, hvis du måler på dag to.
Begrænsningen er skalaen: kontrollen gælder hele propertyen. Du kan ikke tage din ene kannibaliserede vejledning ud af AI-oversigterne og lade resten af sitet blive. Og du har ikke tallene til at træffe valget: rapporten for generativ AI viser visninger, ikke klik eller klikrate, selvom CMA's egne noter nævner netop klik og klikrate som det publicister bør have. Du bliver altså bedt om at beslutte, om du vil ud af en overflade, hvis trafikbidrag du ikke kan se.
nosnippet er stadig den dyre udvej
Den gamle metode virker fortsat og er den eneste der arbejder på sideniveau i dag. Den er også alt-eller-intet: fjerner du snippet-materialet, fjerner du både det AI-svaret kunne bygge på og det uddrag der står under din titel i resultatlisten. På en side der rangerer, er det et mærkbart indgreb for at undgå et bidrag du ikke kan måle. Jeg bruger den på sider hvor uddraget i forvejen ikke bærer klikket — prislister, tekniske tabeller — og ikke andre steder.
Datoen der betyder noget kommer fra en regulator
Den granulære kontrol, altså AI-fravalg side for side, er ikke noget Google har annonceret af sig selv. Den ligger som en implementeringsfrist i CMA-afgørelsen: ni måneder efter beslutningen, hvilket peger på 3. marts 2027. Cloudflares Accountable-krav lægger sig oveni med en mekanisme til at fravælge AI-resuméer gennem Cloudflare «næste år», og Microsofts robots.txt-understøttelse i begyndelsen af 2027.
Rækkefølgen jeg ville tage det i
Først: læs din egen robots.txt. Hvis der står en Disallow for Google-Extended, du ikke selv har skrevet, er du blandt de migrerede — og du ved nu, hvad den linje gør og ikke gør. Dernæst: åbn Search Console-indstillingen og se den som et separat spørgsmål, ikke som en bekræftelse af det du allerede har slået til i Cloudflare. De to kan stå forskelligt uden at noget er galt.
Og så det, der er svært at gøre bagefter: hav en baseline. Blokering på netværksniveau efterlader ingen 403 i din egen serverlog, fordi forespørgslen aldrig nåede dit origin. Det du ser er ikke en fejl, men et fravær — færre crawl-forespørgsler, sider der bliver ved med at være i «Fundet, ikke indekseret». Uden et målt niveau fra før 15. september er den slags umulig at tilskrive noget bestemt. Notér datoen i din egen log over ændringer, sammen med hvad Cloudflare-panelet faktisk stod på den dag.
Kontakten uden knap
Det er værd at holde fast i, hvem der har leveret hvad her. Cloudflare fik en garanti for, at et træningsfravalg ikke koster dig søgetrafik — det er reelt, og det er mere end branchen havde for to måneder siden. Men den kontrol de fleste egentlig efterspørger, nemlig at holde en enkelt side ude af et AI-svar uden at forsvinde fra resultatlisten, er ikke Cloudflares at levere, og Google har ikke lovet den af sig selv. Den har en dato, fordi en britisk konkurrencemyndighed satte en.
Indtil da er det værste du kan gøre at slå noget til og antage, at det virkede. En knap der skriver en linje i robots.txt føles som en handling. Det er også kun det den er.